为什么这对你很重要
LIA 依赖许多服务:AI 模型、数据库、你的邮箱、你的日历、搜索引擎。每一个都可能悄无声息地出故障。搜索提供商响应变慢,一个任务队列卡住,某天夜里一次备份失败。如果没人看到,发现它的就是你,而且是在最不合适的时候,表现为一个空的回答,或一条没有到来的提醒。
我希望运营一个实例的人能比他的用户更早看到这些问题,能一路追溯到原因,并且他读到的数字说的是真话。
三种观察方式
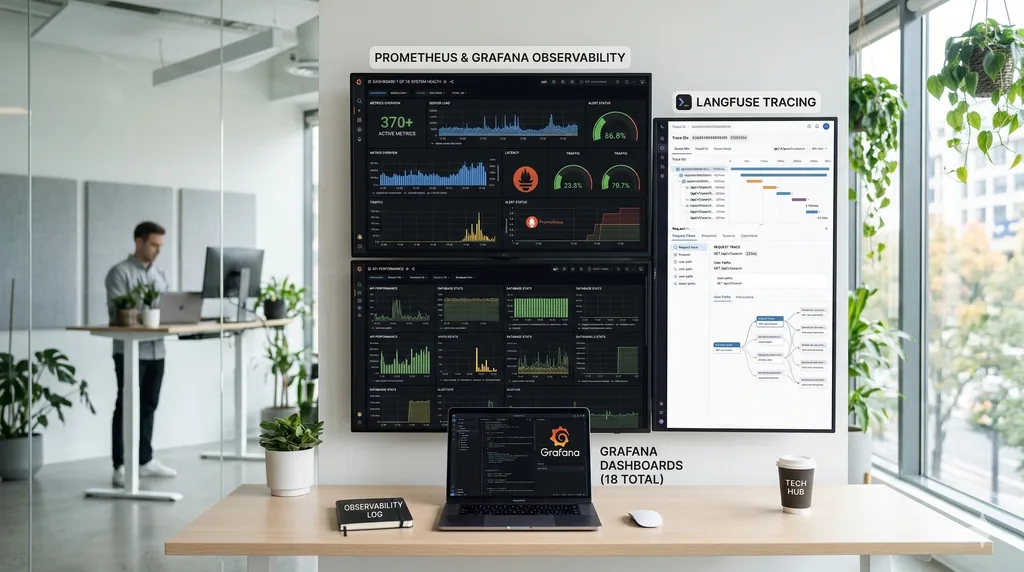
- 指标:数百个计数器跟踪请求、模型调用、消耗的 token、费用、连接器或语音。三十来个仪表板让它们一目了然。
- 日志:每个事件都以结构化形式写下,并汇集到同一个地方。它们记录的是事实,比如数字、标识符或错误码;人们说的话不会进入日志。
- 追踪:一条追踪从头到尾、一步一步地跟随一个请求。如果运营者开启,一个专门面向 AI 模型的工具 Langfuse 还会跟踪每一次调用:使用的模型、token、响应时间、费用。
这些信号彼此呼应。一行日志可以打开它所属请求的追踪,一条追踪可以打开它的日志和指标,一个延迟峰值可以打开造成它的那个具体样例。其中的页面按其形态命名,比如「某段关系的详情页」:网址中包含的姓名或搜索内容不会出现在那里。
举个具体的例子。一个回答迟迟不来,慢得反常。聊天的仪表板显示了这次上升;点击最慢的那个点,会打开这一轮的追踪;追踪显示等待来自搜索服务,它的日志说明了服务返回了什么错误码。没有这些链接,就得手动比对时间戳。
得到通知
为了让运营者不必一直盯着屏幕,有一组核心告警会持续评估,并通过电子邮件发送:API、数据库或缓存不可用,磁盘或内存已满,服务器错误,响应过慢,备份失败,公网地址无法访问,证书即将过期。每条告警都指向一份写好的运维手册,测试会确认邮件中显示的阈值正是触发它的那个阈值。
慢响应告警只关注有人在等待的那些轮次:夜里运行的例程,不会让任何人干等。而传送这些信号的链路本身也受到监控:如果日志在途中丢失,会有一条告警发出提醒。
LIA 读取自己的健康状况
当运营者启用这项功能时,LIA 会定期自己做一次检查:错误率、响应时间、模型失败、磁盘、内存、数据库。描述同一个故障的信号会合并成一个事件。一个专门的模型会阅读收集到的材料和为这种情况写好的运维手册,然后提出一个可能的原因和一些操作建议。这些都是给人看的建议:什么都不会被执行。管理员可以在「平台健康」页面看到全部内容,每个诊断下面都附有模型读过的东西。
对你来说,效果并不显眼:当某个服务已知出了故障时,LIA 会在计划之前就知道,并绕开它:你不用等到超时才知道。
不说谎的数字
我还希望这些数字是准确的。一个工具失败时,往往是返回一个失败结果,而不是抛出错误;一个只盯着错误的计数器会把它当成成功。所以,只有一个标准来决定什么算成功,登记簿和指标都用它。对于按含义的搜索,当一次调用被重试时,有一个计数器会说明调用方最终是否拿到了结果,这样一次被挽回的失败就不会抬高错误率。最后,一个指标必须被某个仪表板、规则或告警读取:一个没人读的新指标会让构建失败,而尚待接入的旧指标,清单只会越来越短。
局限
这一切的前提是运营者部署了监控栈并配置了邮件发送。没有它,LIA 照样运行,但她的健康检查只限于她自己的直接检查。告警只是提醒,它不负责修复。而最详细的日志级别在生产环境中是关闭的,它会保留更多信息:仅限开发时使用。更多细节见可观测性的技术说明。