Perché ti riguarda
LIA dipende da molti servizi: modelli di IA, un database, la tua posta, il tuo calendario, un motore di ricerca. Ognuno può guastarsi in modo silenzioso. Il fornitore di ricerca risponde lentamente, una coda di attività si blocca, un backup fallisce una notte. Se nessuno se ne accorge, sei tu a scoprirlo, nel momento sbagliato, sotto forma di una risposta vuota o di un promemoria che non arriva.
Volevo che chi gestisce un'istanza vedesse questi problemi prima dei suoi utenti, che potesse risalire fino alla loro causa, e che i numeri che legge dicessero la verità.
Tre modi di guardare
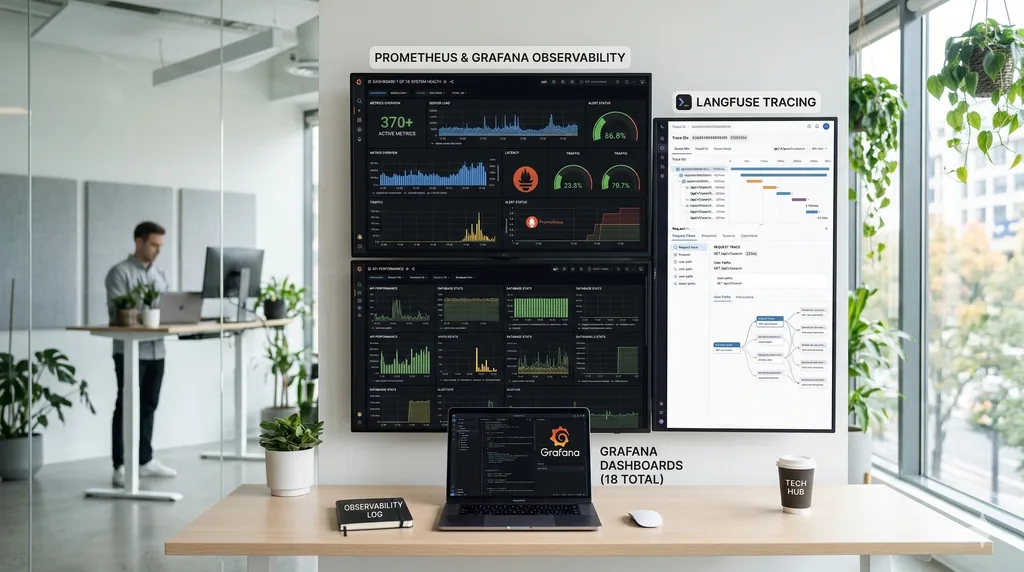
- Metriche: centinaia di contatori seguono le richieste, le chiamate ai modelli, i token consumati, i costi, i connettori o la voce. Una trentina di dashboard li rendono leggibili.
- Log: ogni evento viene scritto in forma strutturata e raccolto nello stesso posto. Portano fatti, come numeri, identificativi o codici di errore; le parole delle persone non ci entrano.
- Tracce: una traccia segue una richiesta da un capo all'altro, passaggio per passaggio. Se l'operatore lo attiva, uno strumento dedicato ai modelli di IA, Langfuse, segue in più ogni chiamata: il modello usato, i token, il tempo di risposta, il costo.
Questi segnali si richiamano a vicenda. Una riga di log apre la traccia della sua richiesta, una traccia apre i suoi log e le sue metriche, un picco di latenza apre l'esempio preciso che l'ha prodotto. Le pagine vi sono indicate per la loro forma, «la scheda di una relazione»: il nome o la ricerca contenuti in un indirizzo non vi compaiono.
Facciamo un caso concreto. Una risposta impiega un tempo anomalo ad arrivare. La dashboard della chat mostra l'aumento; un clic sul punto più lento apre la traccia di quel turno; la traccia mostra che l'attesa viene dal servizio di ricerca, e i suoi log dicono quale codice ha restituito. Senza questi collegamenti bisognerebbe incrociare a mano gli orari.
Essere avvisati
Perché l'operatore non debba tenere d'occhio i suoi schermi, un nucleo di allarmi viene valutato di continuo e inviato per e-mail: API, database o cache non disponibili, disco o memoria saturi, errori del server, risposte troppo lente, backup fallito, indirizzo pubblico irraggiungibile, certificato vicino alla scadenza. Ogni allarme rimanda a una procedura di risoluzione scritta, e dei test verificano che la soglia mostrata nell'e-mail sia proprio quella che lo fa scattare.
L'allarme di lentezza guarda solo i turni che una persona sta aspettando: una routine che gira di notte non ha nessuno da far aspettare. E la catena che trasporta questi segnali è a sua volta sorvegliata: un allarme avvisa se dei log si perdono per strada.
LIA legge la propria salute
Quando l'operatore attiva questa funzione, LIA fa da sola un controllo regolare: tasso di errori, tempi di risposta, fallimenti dei modelli, disco, memoria, database. I segnali che descrivono lo stesso guasto vengono raggruppati in un solo incidente. Un modello dedicato legge gli elementi raccolti e la procedura scritta per quel caso, poi propone una causa probabile e delle azioni. Sono proposte per una persona: nulla viene eseguito. Gli amministratori vedono tutto nella pagina Salute della piattaforma, con, sotto ogni diagnosi, ciò che il modello ha letto.
Per te l'effetto è discreto: quando un servizio è noto come guasto, LIA lo sa prima di pianificare e lo aggira: non aspetti che scada un tempo di attesa per scoprirlo.
Numeri che non mentono
Volevo anche che questi numeri fossero giusti. Uno strumento spesso fallisce restituendo un fallimento, senza sollevare un errore, e un contatore che guardasse solo gli errori lo scambierebbe per un successo. Un solo criterio decide quindi cos'è un successo, per i registri come per le metriche. Per la ricerca per significato, quando una chiamata viene ritentata, un contatore dice se chi l'ha fatta ha alla fine ottenuto il suo risultato, perché un fallimento recuperato non gonfi il tasso di errore. Infine, una metrica deve essere letta da una dashboard, una regola o un allarme: una nuova metrica che nessuno legge fa fallire la build, e l'elenco di quelle vecchie ancora da collegare può solo accorciarsi.
I limiti
Tutto questo presuppone che l'operatore installi lo stack di monitoraggio e configuri l'invio delle e-mail. Senza, LIA funziona, ma il suo controllo di salute si limita alle sue verifiche dirette. Un allarme avvisa, non ripara. E il livello di log più dettagliato, spento in produzione, conserva più informazioni: è riservato allo sviluppo. Più dettagli sull'osservabilità, lato tecnico.
Per approfondire: Vedere LIA lavorare: i passaggi che compaiono mentre aspetti; Regolare i modelli di LIA senza riavviare, e senza configurazioni impossibili.