Pourquoi ça compte pour toi
LIA dépend de nombreux services : des modèles d'IA, une base de données, ta messagerie, ton agenda, un moteur de recherche. Chacun peut tomber en panne de façon discrète. Le fournisseur de recherche répond lentement, une file de tâches se bloque, une sauvegarde échoue une nuit. Si personne ne le voit, c'est toi qui le découvres, au mauvais moment, sous la forme d'une réponse vide ou d'un rappel qui n'arrive pas.
Je voulais que la personne qui opère une instance voie ces problèmes avant ses utilisateurs, qu'elle puisse remonter jusqu'à leur cause, et que les chiffres qu'elle lit disent la vérité.
Trois façons de regarder
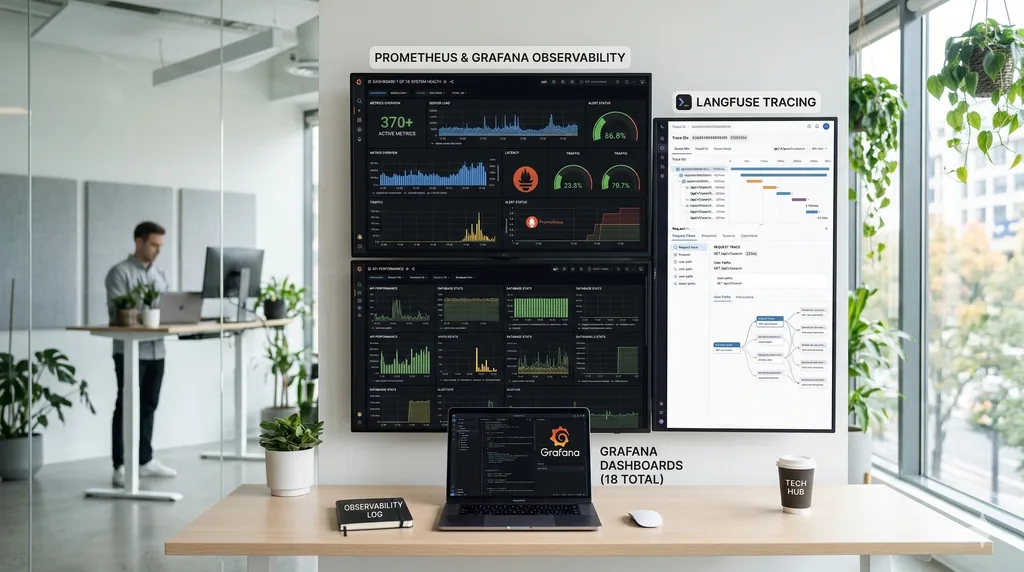
- Des métriques : des centaines de compteurs suivent les requêtes, les appels aux modèles, les jetons consommés, les coûts, les connecteurs ou la voix. Une trentaine de tableaux de bord les rendent lisibles.
- Des journaux : chaque événement est écrit sous une forme structurée et rassemblé au même endroit. Ils portent des faits, comme des nombres, des identifiants ou des codes d'erreur ; les mots des personnes n'y entrent pas.
- Des traces : une trace suit une requête d'un bout à l'autre, étape par étape. Si l'opérateur l'active, un outil dédié aux modèles d'IA, Langfuse, suit en plus chaque appel : le modèle utilisé, les jetons, le temps de réponse, le coût.
Ces signaux se répondent. Une ligne de journal ouvre la trace de sa requête, une trace ouvre ses journaux et ses métriques, un pic de latence ouvre l'exemple précis qui l'a produit. Les pages y sont nommées par leur forme, « la fiche d'une relation » : le nom ou la recherche qu'une adresse contient n'y figure pas.
Prenons un cas concret. Une réponse met anormalement longtemps à arriver. Le tableau de bord du chat montre la hausse ; un clic sur le point le plus lent ouvre la trace de ce tour ; la trace montre que l'attente vient du service de recherche, et ses journaux disent quel code il a renvoyé. Sans ces liens, il faudrait recouper des horodatages à la main.
Être prévenu
Pour que l'opérateur n'ait pas à guetter ses écrans, un noyau d'alertes est évalué en continu et envoyé par e-mail : API, base de données ou cache indisponibles, disque ou mémoire saturés, erreurs serveur, réponses trop lentes, sauvegarde ratée, adresse publique injoignable, certificat proche de l'expiration. Chaque alerte renvoie à une procédure de résolution écrite, et des tests vérifient que le seuil affiché dans l'e-mail est bien celui qui la déclenche.
L'alerte de lenteur ne regarde que les tours qu'une personne attend : une routine qui tourne la nuit n'a personne à faire patienter. Et la chaîne qui transporte ces signaux est elle-même surveillée : une alerte prévient si des journaux se perdent en route.
LIA lit sa propre santé
Quand l'opérateur l'active, LIA fait elle-même un bilan régulier : taux d'erreurs, temps de réponse, échecs des modèles, disque, mémoire, base de données. Les signaux qui décrivent la même panne se regroupent en un seul incident. Un modèle dédié lit les éléments recueillis et la procédure écrite pour ce cas, puis propose une cause probable et des actions. Ce sont des propositions pour une personne : rien n'est exécuté. Les administrateurs voient tout dans la page Santé de la plateforme, avec, sous chaque diagnostic, ce que le modèle a lu.
Pour toi, l'effet est discret : quand un service est connu comme en panne, LIA le sait avant de planifier et le contourne : tu n'attends pas qu'un délai expire pour l'apprendre.
Des chiffres qui ne mentent pas
Je voulais aussi que ces chiffres soient justes. Un outil échoue souvent en renvoyant un échec, sans lever d'erreur, et un compteur qui ne regarderait que les erreurs le prendrait pour un succès. Un seul critère décide donc ce qu'est un succès, pour les registres comme pour les métriques. Pour la recherche par le sens, quand un appel est réessayé, un compteur dit si l'appelant a finalement obtenu son résultat, pour qu'un échec rattrapé ne gonfle pas le taux d'erreur. Enfin, une métrique doit être lue par un tableau de bord, une règle ou une alerte : une nouvelle métrique que personne ne lit fait échouer la construction, et la liste des anciennes qui restent à brancher ne peut que raccourcir.
Les limites
Tout cela suppose que l'opérateur déploie la pile de supervision et configure l'envoi des e-mails. Sans elle, LIA fonctionne, mais son bilan de santé se limite à ses vérifications directes. Une alerte prévient, elle ne répare pas. Et le niveau de journal le plus détaillé, coupé en production, garde davantage d'informations : il est réservé au développement. Plus de détails sur l'observabilité, côté technique.
Pour approfondir : Voir LIA travailler : les étapes qui s'affichent pendant que tu attends ; Régler les modèles de LIA sans redémarrer, et sans configuration impossible.