Warum das für dich zählt
LIA hängt von vielen Diensten ab: KI-Modellen, einer Datenbank, deinem Mailkonto, deinem Kalender, einer Suchmaschine. Jeder davon kann unauffällig ausfallen. Der Suchanbieter antwortet langsam, eine Aufgabenwarteschlange hängt, eine Sicherung scheitert eines Nachts. Wenn das niemand sieht, entdeckst du es, im falschen Moment, als leere Antwort oder als Erinnerung, die nicht ankommt.
Ich wollte, dass die Person, die eine Instanz betreibt, diese Probleme vor ihren Nutzern sieht, dass sie bis zu ihrer Ursache zurückgehen kann und dass die Zahlen, die sie liest, die Wahrheit sagen.
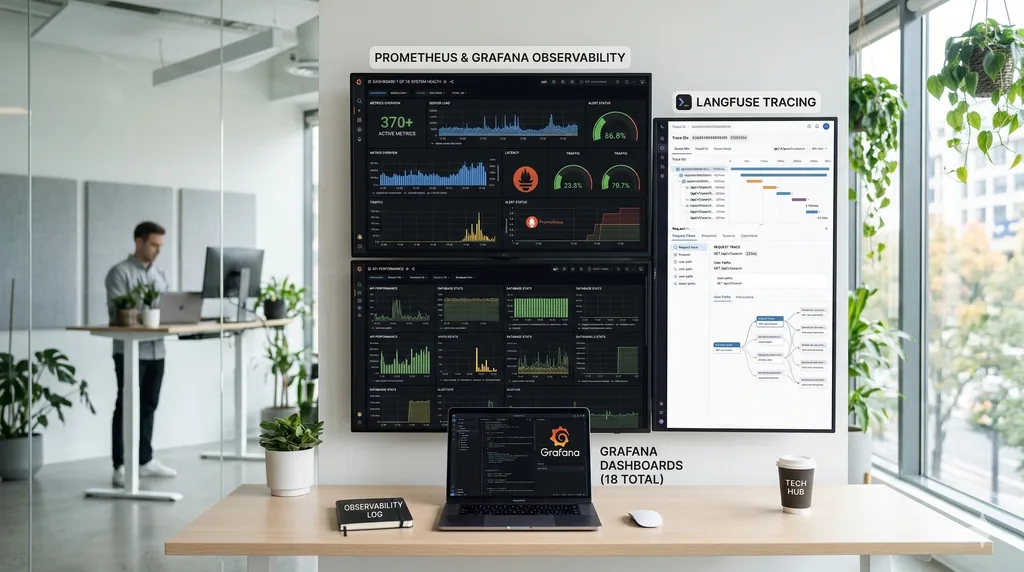
Drei Arten hinzusehen
- Metriken: Hunderte Zähler verfolgen die Anfragen, die Modellaufrufe, die verbrauchten Token, die Kosten, die Konnektoren oder die Stimme. Rund dreißig Dashboards machen sie lesbar.
- Logs: Jedes Ereignis wird in strukturierter Form geschrieben und an einem Ort gesammelt. Die Logs enthalten Fakten, etwa Zahlen, Kennungen oder Fehlercodes; die Worte der Menschen kommen darin nicht vor.
- Traces: Ein Trace verfolgt eine Anfrage von einem Ende zum anderen, Schritt für Schritt. Wenn der Betreiber es aktiviert, verfolgt ein auf KI-Modelle spezialisiertes Werkzeug, Langfuse, zusätzlich jeden Aufruf: das verwendete Modell, die Token, die Antwortzeit, die Kosten.
Diese Signale verweisen aufeinander. Eine Logzeile öffnet den Trace ihrer Anfrage, ein Trace öffnet seine Logs und Metriken, eine Latenzspitze öffnet das konkrete Beispiel, das sie verursacht hat. Seiten werden dort nach ihrer Form benannt, „die Seite einer Beziehung“: Der Name oder die Suche, die eine Adresse enthält, taucht dort nicht auf.
Nehmen wir einen konkreten Fall. Eine Antwort braucht ungewöhnlich lange. Das Dashboard des Chats zeigt den Anstieg; ein Klick auf den langsamsten Punkt öffnet den Trace dieser Runde; der Trace zeigt, dass die Wartezeit vom Suchdienst kommt, und seine Logs sagen, welchen Code er zurückgegeben hat. Ohne diese Verknüpfungen müsste man Zeitstempel von Hand abgleichen.
Gewarnt werden
Damit der Betreiber nicht ständig seine Bildschirme im Blick behalten muss, wird ein Kern von Alarmen laufend ausgewertet und per E-Mail verschickt: API, Datenbank oder Cache nicht verfügbar, Festplatte oder Speicher voll, Serverfehler, zu langsame Antworten, gescheiterte Sicherung, öffentliche Adresse nicht erreichbar, Zertifikat kurz vor dem Ablauf. Jeder Alarm verweist auf eine schriftliche Lösungsanleitung, und Tests prüfen, dass der in der E-Mail angezeigte Schwellenwert genau der ist, der ihn auslöst.
Der Alarm für Langsamkeit betrachtet nur die Runden, auf die ein Mensch wartet: Eine Routine, die nachts läuft, lässt niemanden warten. Und die Kette, die diese Signale transportiert, wird selbst überwacht: Ein Alarm warnt, wenn unterwegs Logs verloren gehen.
LIA liest ihren eigenen Zustand
Wenn der Betreiber es aktiviert, zieht LIA selbst regelmäßig Bilanz: Fehlerraten, Antwortzeiten, Fehlschläge der Modelle, Festplatte, Speicher, Datenbank. Signale, die dieselbe Störung beschreiben, werden zu einem einzigen Vorfall zusammengefasst. Ein eigenes Modell liest die gesammelten Elemente und die für diesen Fall geschriebene Anleitung und schlägt dann eine wahrscheinliche Ursache und Maßnahmen vor. Das sind Vorschläge für einen Menschen: Nichts wird ausgeführt. Administratoren sehen alles auf der Seite Plattformzustand, unter jeder Diagnose mit dem, was das Modell gelesen hat.
Für dich ist die Wirkung unauffällig: Wenn ein Dienst als ausgefallen bekannt ist, weiß LIA es, bevor sie plant, und umgeht ihn: Du wartest nicht, bis eine Zeitgrenze abläuft, um es zu erfahren.
Zahlen, die nicht lügen
Ich wollte auch, dass diese Zahlen stimmen. Ein Werkzeug scheitert oft, indem es einen Fehlschlag zurückgibt, ohne einen Fehler auszulösen, und ein Zähler, der nur auf Fehler achtete, würde das für einen Erfolg halten. Ein einziges Kriterium entscheidet deshalb, was ein Erfolg ist, für die Register wie für die Metriken. Bei der Suche nach Bedeutung sagt ein Zähler, wenn ein Aufruf wiederholt wird, ob der Aufrufer am Ende sein Ergebnis bekommen hat, damit ein aufgefangener Fehlschlag die Fehlerquote nicht aufbläht. Und schließlich muss eine Metrik von einem Dashboard, einer Regel oder einem Alarm gelesen werden: Eine neue Metrik, die niemand liest, lässt den Build scheitern, und die Liste der alten, die noch angeschlossen werden müssen, kann nur kürzer werden.
Die Grenzen
All das setzt voraus, dass der Betreiber den Überwachungs-Stack bereitstellt und den E-Mail-Versand einrichtet. Ohne ihn funktioniert LIA, aber ihre Zustandsbilanz beschränkt sich auf ihre direkten Prüfungen. Ein Alarm warnt, er repariert nicht. Und die ausführlichste Log-Stufe, die in der Produktion abgeschaltet ist, behält mehr Informationen: Sie ist der Entwicklung vorbehalten. Mehr dazu unter Observability, die technische Seite.
Weiterlesen: LIA bei der Arbeit zusehen: die Schritte, die erscheinen, während du wartest; LIAs Modelle einstellen, ohne Neustart und ohne unmögliche Konfiguration.